

 입력 2026-08-27 16:25:04


5개 정예팀 구축 AI 학습데이터 29종 AI허브 통해 공개
LG 피지컬AI·SKT 추론·업스테이지 사전학습 등 AI 개발 전략 담겨
70~80B급 모델 학습 가능…스타트업·연구진 데이터 진입장벽 낮춰
배경훈 부총리 겸 과기정통부 장관. <출처=연합뉴스>
정부의 ‘독자 인공지능(AI) 파운데이션 모델’ 프로젝트가 단순이 국가대표 AI 모델을 선정하는 경쟁을 넘어 국내 AI 생태계의 공통 자산을 축적하는 단계로 확장되고 있다. AI 정예팀들이 자체 모델의 성능을 끌어올리기 위해 구축한 대규모 학습데이터를 민간에 개방, 활용도를 극대화 한다. 정부 지원을 받아 확보한 모델 개발 성과가 스타트업과 연구기관, 학생 등이 활용할 수 있는 공용 AI 인프라로 재탄생 할 것으로 보인다.
27일 과학기술정보통신부와 한국지능정보사회진흥원(NIA)에 따르면 ‘독자 AI 파운데이션 모델’ 프로젝트에 참여한 5개 정예팀이 1차 단계평가 과정에서 확보한 AI 학습용 데이터 29종이 AI허브를 통해 본격 개방된다. 공개되는 데이터는 약 3544만건, 1조5600억 토큰 규모다.
과기정통부는 이 정도 데이터면 이론적으로 70~80B(700억~800억개 매개변수) 수준의 대형 AI 모델 학습에도 활용할 수 있는 규모라고 설명했다.
‘독자 AI 파운데이션 모델’ 개방의 핵심은 단순한 데이터의 양보다 각각의 데이터에 참여 기업의 AI 개발 전략이 녹아 있다는 점이다.
LG AI연구원, SK텔레콤, 업스테이지, 네이버클라우드, NC AI 등 5개 정예팀은 지난해 정부가 지원한 데이터 구축·가공 예산 150억원을 활용해 각자 모델 개발 방향에 필요한 데이터를 직접 기획하고 구축했다. 대규모 사전학습 데이터부터 전문영역 추론, 영상·음성 기반 멀티모달, AI 안전성을 점검하는 레드티밍, 피지컬 AI 학습용 데이터까지 종류도 다양하다. 독파모 경쟁 과정에서 각 기업이 축적한 일종의 ‘AI 학습 레시피’가 민간에 공개되는 셈이다.
팀별 데이터 구성을 보면 각사가 모델 경쟁력을 어디에서 확보하려 했는지도 드러난다.
LG AI연구원은 최근 글로벌 AI 업계의 새로운 경쟁축으로 떠오른 피지컬 AI에 초점을 맞췄다. 한국 가정환경에 최적화된 멀티모달 데이터셋을 만들기 위해 국내 50개 실제 가정에서 50종 이상의 가사 활동을 직접 촬영해 17만개 이상의 영상 클립을 구축했다. 여기에 객체와 영역 분할, 사람의 자세, 주변 맥락 정보 등을 다층으로 라벨링해 AI가 현실 공간과 사물, 인간의 행동을 함께 이해하도록 설계했다. 비전언어모델(VLM)이나 휴머노이드 로봇의 장면 이해·행동 학습 등에 활용할 수 있는 데이터다. 실제 공개 목록에는 ‘휴머노이드 로봇을 위한 씬 언더스탠딩(Scene Understanding) 데이터셋’ 이미지 15만1952건과 텍스트 1302건 등이 담겼다.
SK텔레콤은 수학·과학·법률 등 전문 분야의 고난도 다단계 추론 데이터에 무게를 뒀다. 음성과 이미지 기반 사후학습 데이터와 함께 국내 법령과 한국 사회의 보편적 가치관을 반영한 ‘한국형 레드티밍’ 데이터 약 1만건도 구축했다. 모델의 추론 성능뿐 아니라 국내 환경에 맞는 안전성과 신뢰성을 함께 높이기 위한 전략이다.
업스테이지는 5개팀 가운데 가장 큰 1조 토큰 규모의 사전학습 데이터를 내놓는다. 여기에 지식·지능 데이터 30만건, 사용자 선호 반영 데이터 10만건, 에이전트 행위 능력 데이터 10만건 등이 포함됐다. 사전학습 데이터는 대규모 AI 모델을 처음부터 학습하는 데 활용할 수 있고, 사후학습 데이터는 단순 질의응답을 넘어 추론·판단·실행까지 수행하는 AI 에이전트 개발에 쓰일 수 있다.
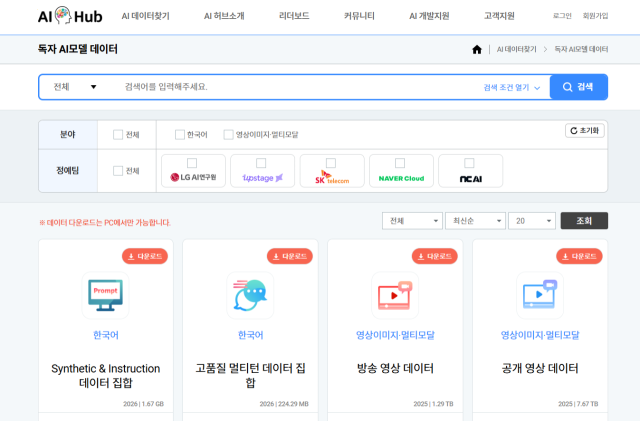
‘독자 AI 파운데이션 모델’ 프로젝트에 참여한 5개 정예팀이 1차 단계평가 과정에서 확보한 AI 학습용 데이터 29종이 AI허브를 통해 본격 개방된다. <이미지=AI허브 홈페이지 화면 갈무리>
네이버클라우드는 공개 영상 234만건과 방송 영상 52만건을 비롯해 해당 영상 클립을 기반으로 한 텍스트 1550만건, 음성 질의응답 1200만건 등을 구축했다. 장면을 문장 단위로 설명한 캡션 등이 포함돼 AI의 영상 이해 능력이나 이미지 생성 모델 학습 등에 활용할 수 있다. 텍스트 중심의 거대언어모델(LLM)을 넘어 영상과 음성을 함께 처리하는 멀티모달 역량 강화에 초점을 맞춘 데이터다.
NC AI는 제조 분야 기술문서와 민원상담 음성 등 산업 현장에서 확보한 실제 데이터를 중심으로 학습 자산을 구축했다. 긴 문맥 이해와 단계별 추론, 멀티턴 대화, 질의응답, 멀티모달 등 LLM 핵심 역량을 높이기 위한 데이터 7종으로, 범용 AI보다 제조·공공 등 실제 산업현장에서 활용할 수 있는 AI 개발에 초점을 맞췄다. 공개 목록에는 다국어 사전학습·기계독해 데이터부터 대화·행동 생성형 AI, 의료 AI, 민원 분야 음성 데이터 등이 포함됐다.
정부는 독파모에 투입된 재원이 특정 기업의 모델 성능 향상에만 쓰이지 않도록 데이터 환류 조도 마련했다. 사업 참여 조건에 따라 정부의 구축·가공 예산으로 확보한 데이터 가운데 50% 이상을 개방해야 한다. SK텔레콤과 업스테이지, 네이버클라우드, NC AI는 품질검증 등을 통과한 데이터를 모두 공개하기로 했으며 LG AI연구원도 의무 개방량을 충족하도록 데이터를 통계적으로 선별해 공개한다. NIA와 한국정보통신기술협회(TTA)는 개인정보와 유해성, 라이선스 문제 등을 검증해 공개 대상을 추렸다.
개방 데이터는 국내 기업과 연구자, 학생 등이 AI허브를 통해 무료로 이용할 수 있다. 일부 데이터는 보안이 보장된 온라인 개발공간인 ‘안심존’을 통해 제공된다. 자체적으로 대규모 데이터를 구축하기 구어려운 스타트업과 연구진 입장에서는 파운데이션 모델 개발에 필요한 초기 데이터 확보 부담을 낮출 수 있는 기반이 될 것으로 보인다.
과기정통부는 “개발 과정에서 축적된 경험과 노하우를 통해 AI 생태계 전반의 질적 성장에 기여한다는 점에서 의미가 있다”며 “정예팀의 AI 학습 전략이 담긴 데이터가 국내 AI 생태계의 성장과 자생력 강화의 밑거름이 될 것”이라고 밝혔다.
[CEO스코어데일리 / 김동일 기자 / same91@ceoscore.co.kr]


































































































댓글
[ 300자 이내 / 현재: 0자 ]
현재 총 0개의 댓글이 있습니다.